AI 第一次让我认真,是 Stitch 做的那个原型
AI 第一次让我认真,是 Stitch 做的那个原型
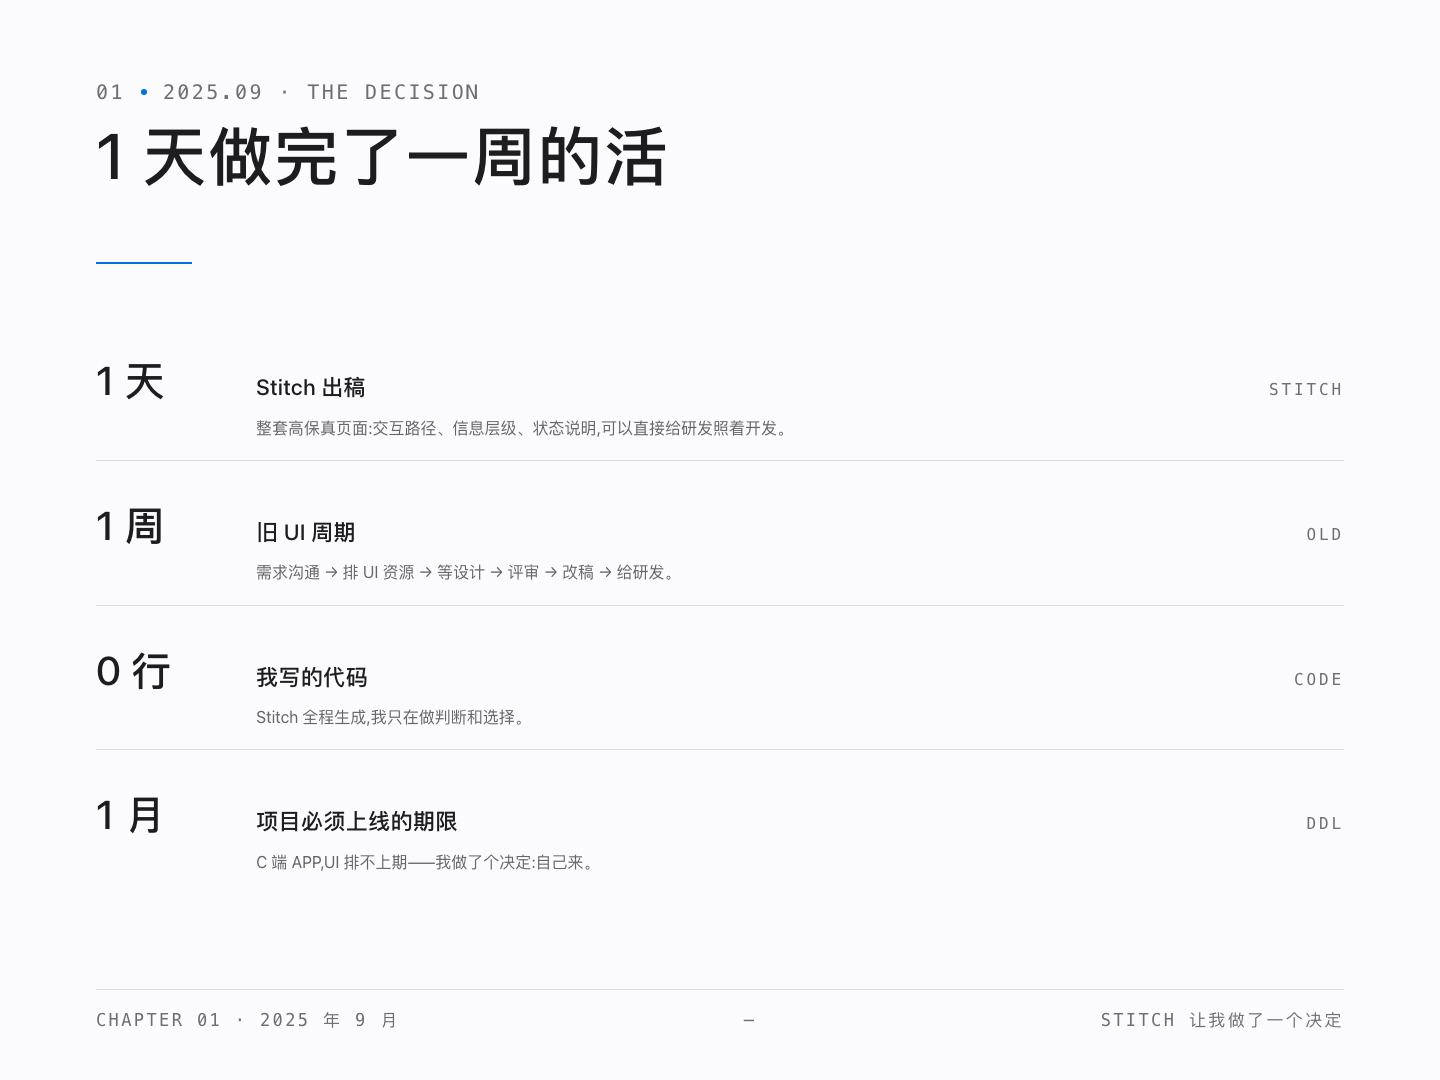
2025 年 9 月,一个 C 端 APP 项目,必须一个月内上线。
UI 资源排不上期。正常流程从需求沟通开始,排 UI 资源、等设计、评审、改稿、再给研发,一个月光等 UI 都不够。
我做了个决定,自己来。
在这之前,我已经用 ChatGPT 用了大半年。一开始只是觉得新鲜,然后开始调 prompt——加角色、给例子、改措辞。不知道这叫 "prompt engineering",只知道调一下,AI 给的东西更好用。我用得最多的是分析需求、头脑风暴、拆设计方案。比搜索引擎舒服,它在帮你想问题,不只是列链接。
但后来我把 prompt 写得越来越细,加了各种约束和格式要求,结果反而让回答变得更僵硬——说正确的废话。我隐隐觉得,这条路已经走到尽头了。
所以那个 C 端项目来的时候,我换了一个思路。
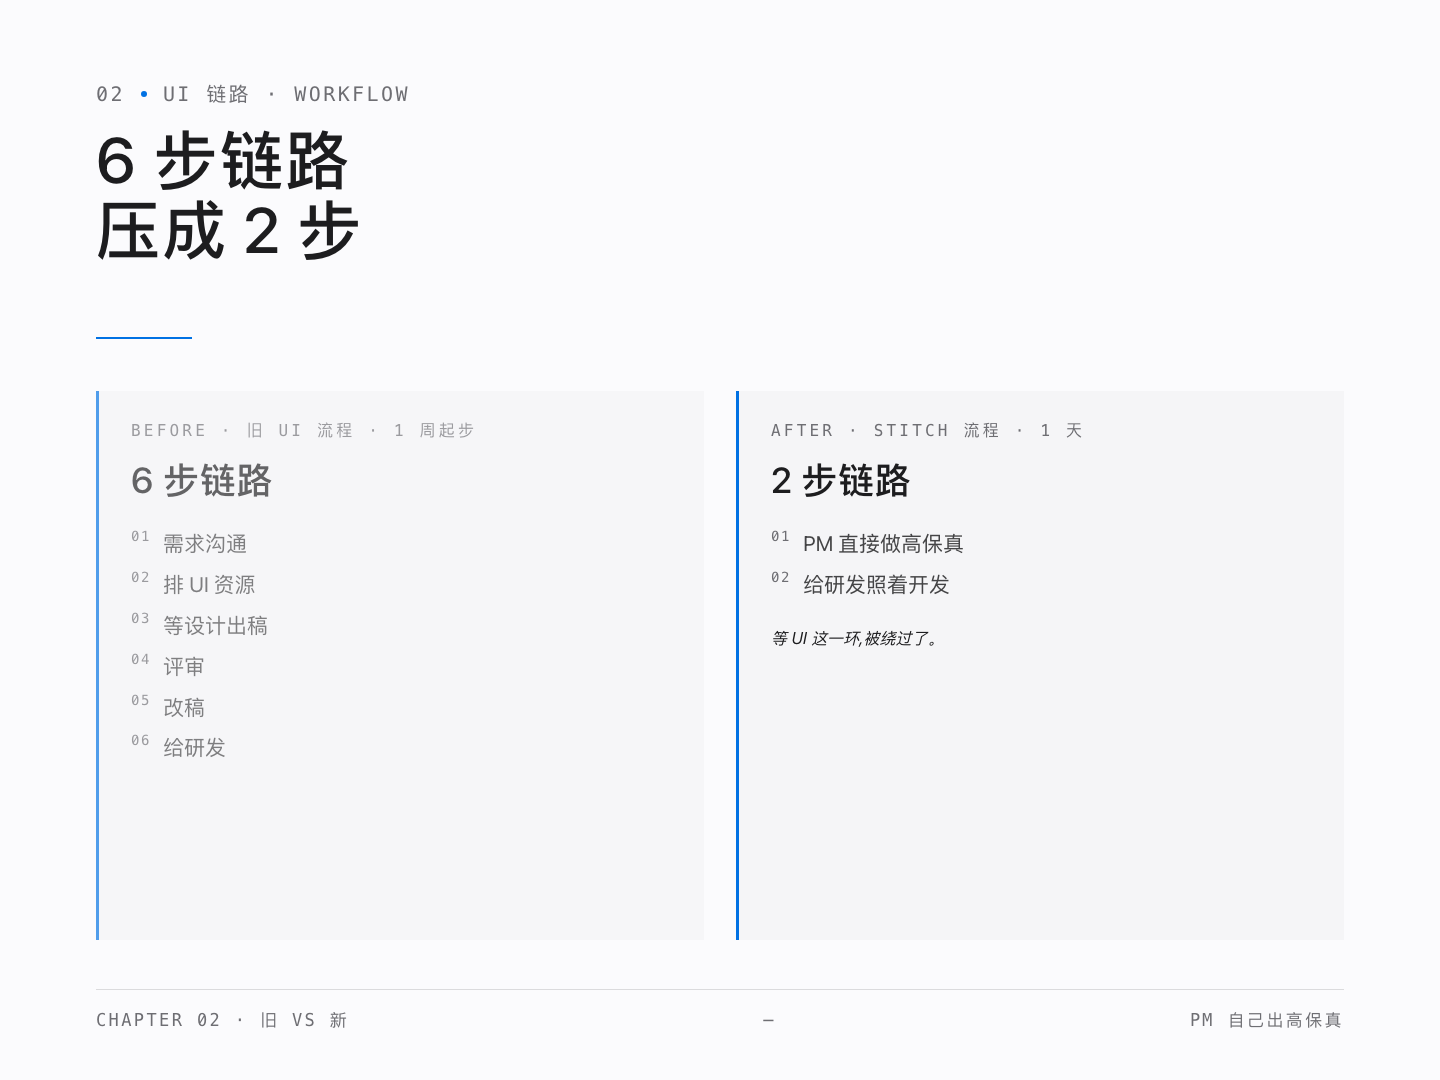
我用 Stitch 直接做了整套带了交互路径、信息层级、状态说明的高保真页面,可以直接给研发照着开发的那种。
做完之后,我反复看了好几遍。以前这种类型的项目,UI 至少要一周,从需求接收到理解再到出稿。现在一天。
我坐在那想了一件事。
需要说清楚:这份高保真的视觉精度和边界考虑,和 UI 设计师出稿不在同一个标准上。这次能直接给研发用,是时间压力下的取舍。
但我还不知道 AI 为什么能做成这样
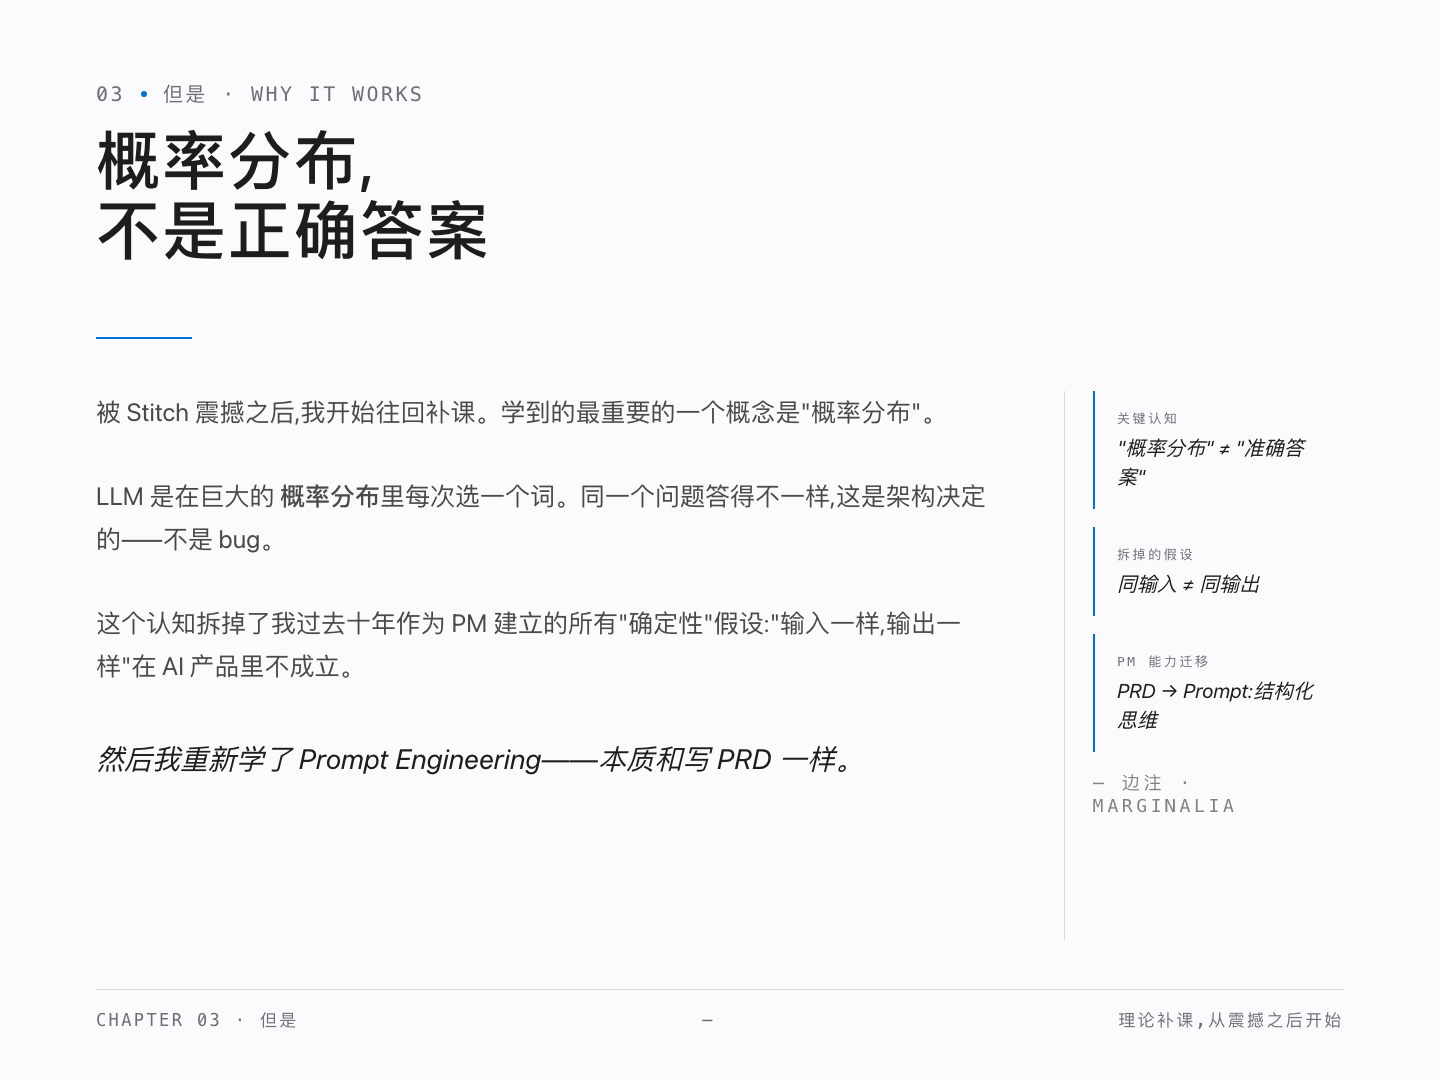
被 Stitch 震撼之后,我开始往回补课。学 LLM 原理。
我学到的最重要的一个概念是"概率分布"。
以前我理解"AI 回答一个问题是准确的"。你问它什么,它答出正确的东西,听起来像是计算。但 LLM 的原理是在一个巨大的概率分布里每次选一个词。同一个问题答得不一样,这是架构决定的。
这个认知直接拆掉了我过去十年作为 PM 建立的所有"确定性"假设。我以前判断一个功能出没出 bug,标准是"输入一样,输出一样"。这条规则在 AI 产品里不成立。
然后我重新学了一遍 Prompt Engineering。
这次开始系统学了。System Prompt、Chain of Thought、Few-shot,原来给例子背后有原理。原来"说清楚角色"是在缩小模型的注意力范围。这些东西和写 PRD 是一样的,结构化思维、边界定义、预期管理。翻译对象变了,但能力底层没变。
回头看,我的路径顺序是反的
大部分人觉得应该"先学习、再实践"。我的经历是先被 Stitch 震撼了,逼我做了一个"自己出高保真"的决定,然后发现 AI 能做的事比我以为的多得多,才回头补的理论和原理。
用 AI 做了一件以前做不到的事,这个动作本身改变了我的工作方式。这条路对我有效——不是说它比先学再实践更好,更可能是被需求逼着做,是比主动学习更有力的触发器,至少对我是。
当时我只知道一件事,那个 C 端 APP 按时上线了。
第 3 篇预告
从那个 C 端 APP 之后,我开始大面积用 AI 干活。2026 年中,我把一个产品完全靠 vibe coding 从 0 到 1 做出来上线了,叫 ai123.com,一行代码没用我写,全部是 AI 生成的。一个人,两个月,做了几年前需要一个团队才能做的事。
但这篇不讲怎么爽,讲的是产能爆发之后遇见的真正瓶颈。AI 在长上下文里会忘记前面的信息、同一段代码同一个人问会给出不同方案、你开始把越来越多的上下文塞给 AI 直到它处理不过来。我花了很长时间才理解,AI 的核心问题是不够稳定。 而稳定,是可以被设计的。